注:本文包含 AI 辅助创作
整体总结
- 背景介绍
- 传统 RL pipeline(如 PPO)多为同步和批量交错(Batch-interleaved)的
- 即先生成一个批次的全部数据,再统一开始训练
- 在长上下文、多轮交互的 Agentic 任务中,轨迹长度高度可变,导致 GPU 集群因等待“慢速”任务而产生大量空闲,效率低下
- 传统 RL pipeline(如 PPO)多为同步和批量交错(Batch-interleaved)的
- 现有问题
- 异步 RL 通过“边生成边训练”缓解了上述问题
- 但现有系统多关注吞吐量,而忽视了训练稳定性与有效性
- 特别是,当前流行的组采样算法(如 GRPO)天然与异步训练不兼容
- 因为组采样会引入 Synchronization Barrier,加剧了策略滞后(Policy Lag)和 Off-Policy 问题
- 异步 RL 通过“边生成边训练”缓解了上述问题
- SAO 的核心贡献 :
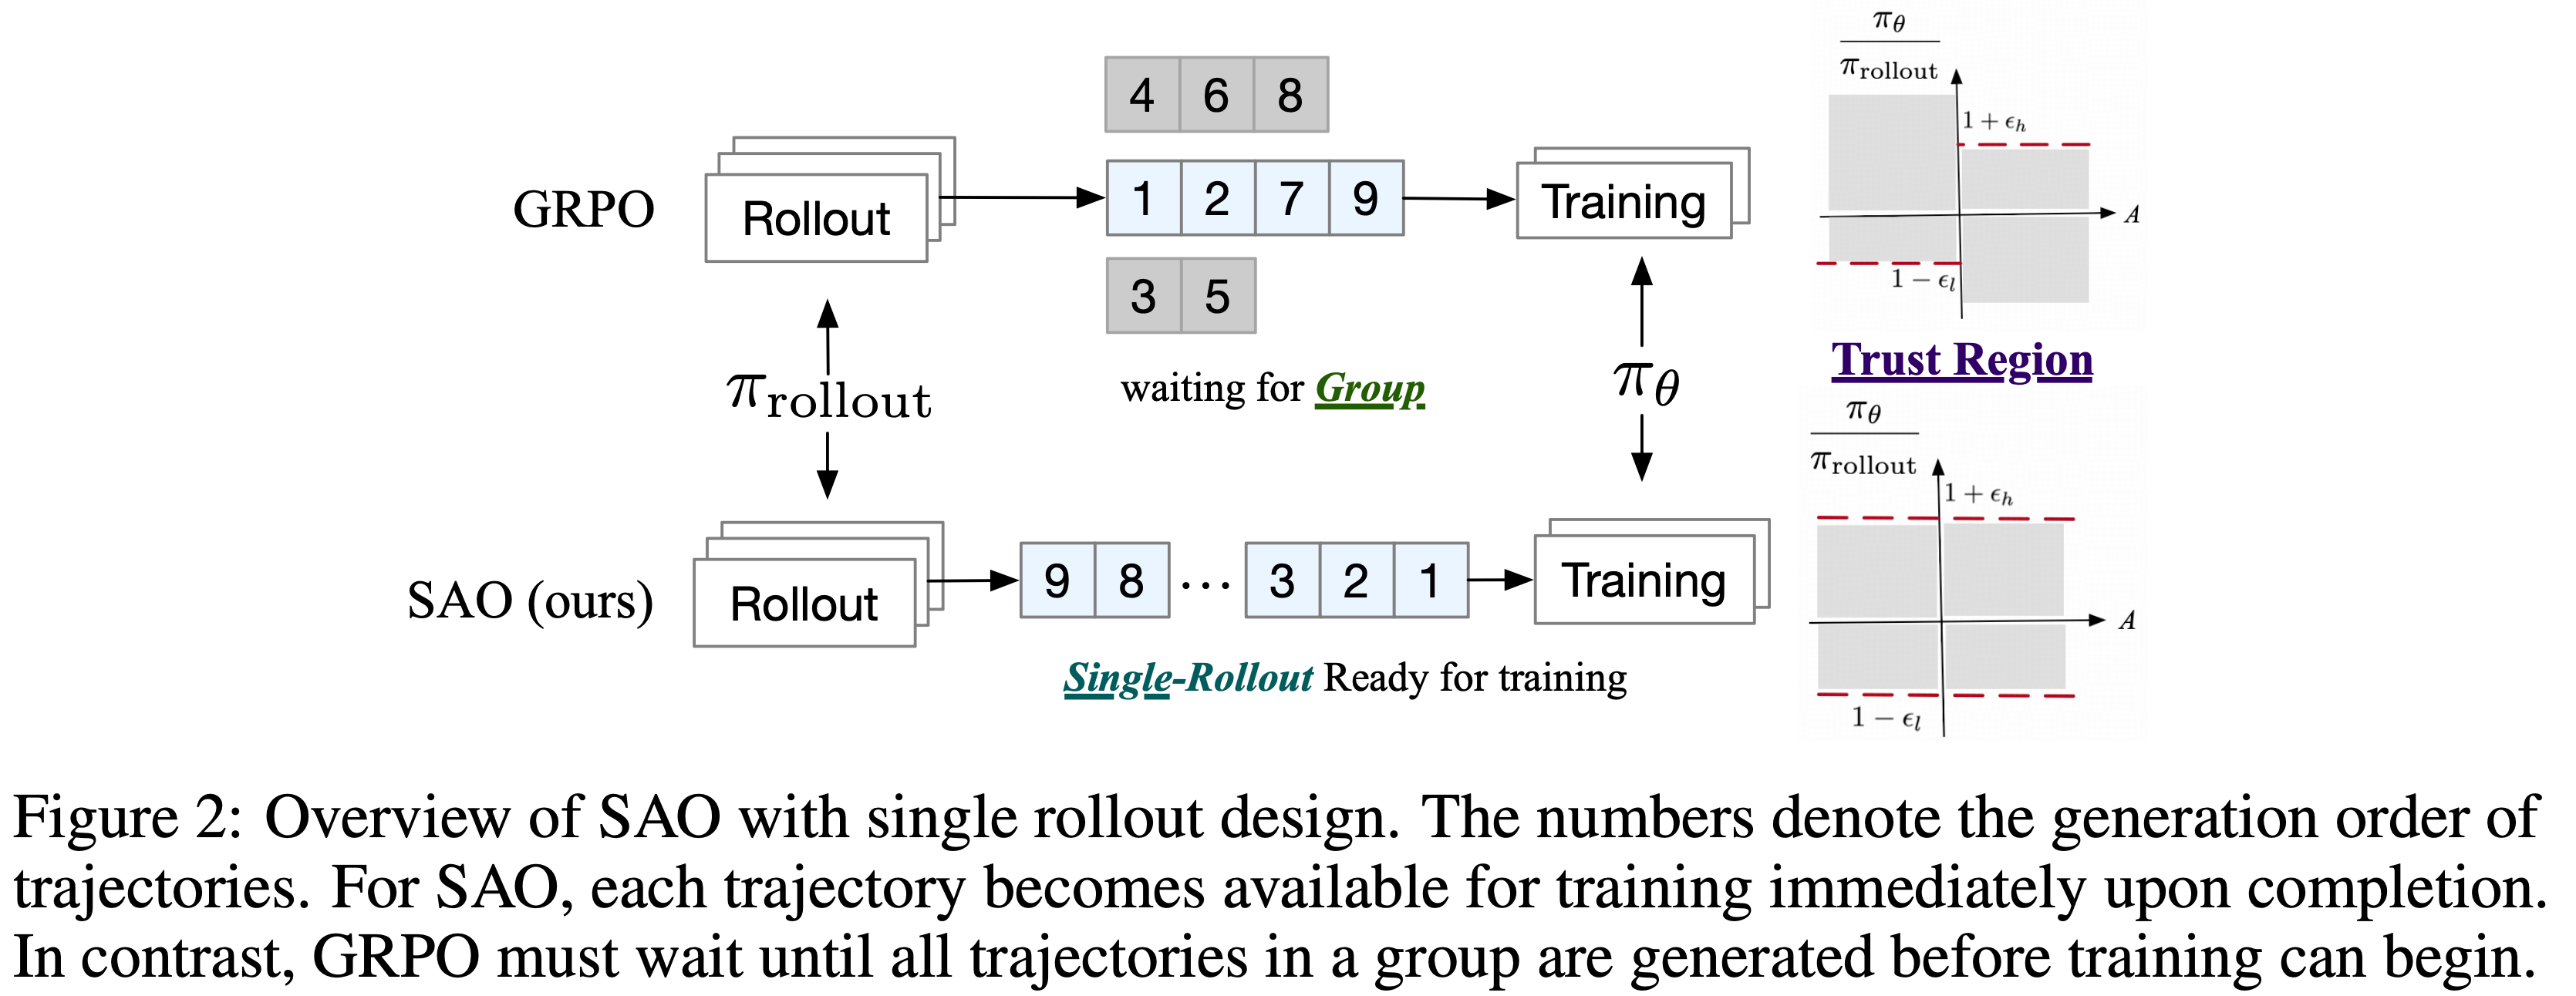
- SAO 用 Single-rollout 采样替代 Group-wise sampling,使数据一生成即可被用于训练,最大化异步效率
- SAO 使用创新的 稳定性机制
- 设计严格的Double-sided Token-level Clipping 与Direct Importance Sampling
- 在不依赖历史策略快照的情况下,有效抑制 Off-Policy 带来的训练崩溃
- 设计严格的Double-sided Token-level Clipping 与Direct Importance Sampling
- SAO 专门做了 Critic 优化 :
- 针对单轨迹采样带来的高方差问题,提出了多个优化:
- 加速 Critic 更新(类似传统 RL)
- 冻结 Critic 的注意力参数
- 针对 Agentic 轨迹的 Skip-Observation GAE 等实用策略
- 针对单轨迹采样带来的高方差问题,提出了多个优化:
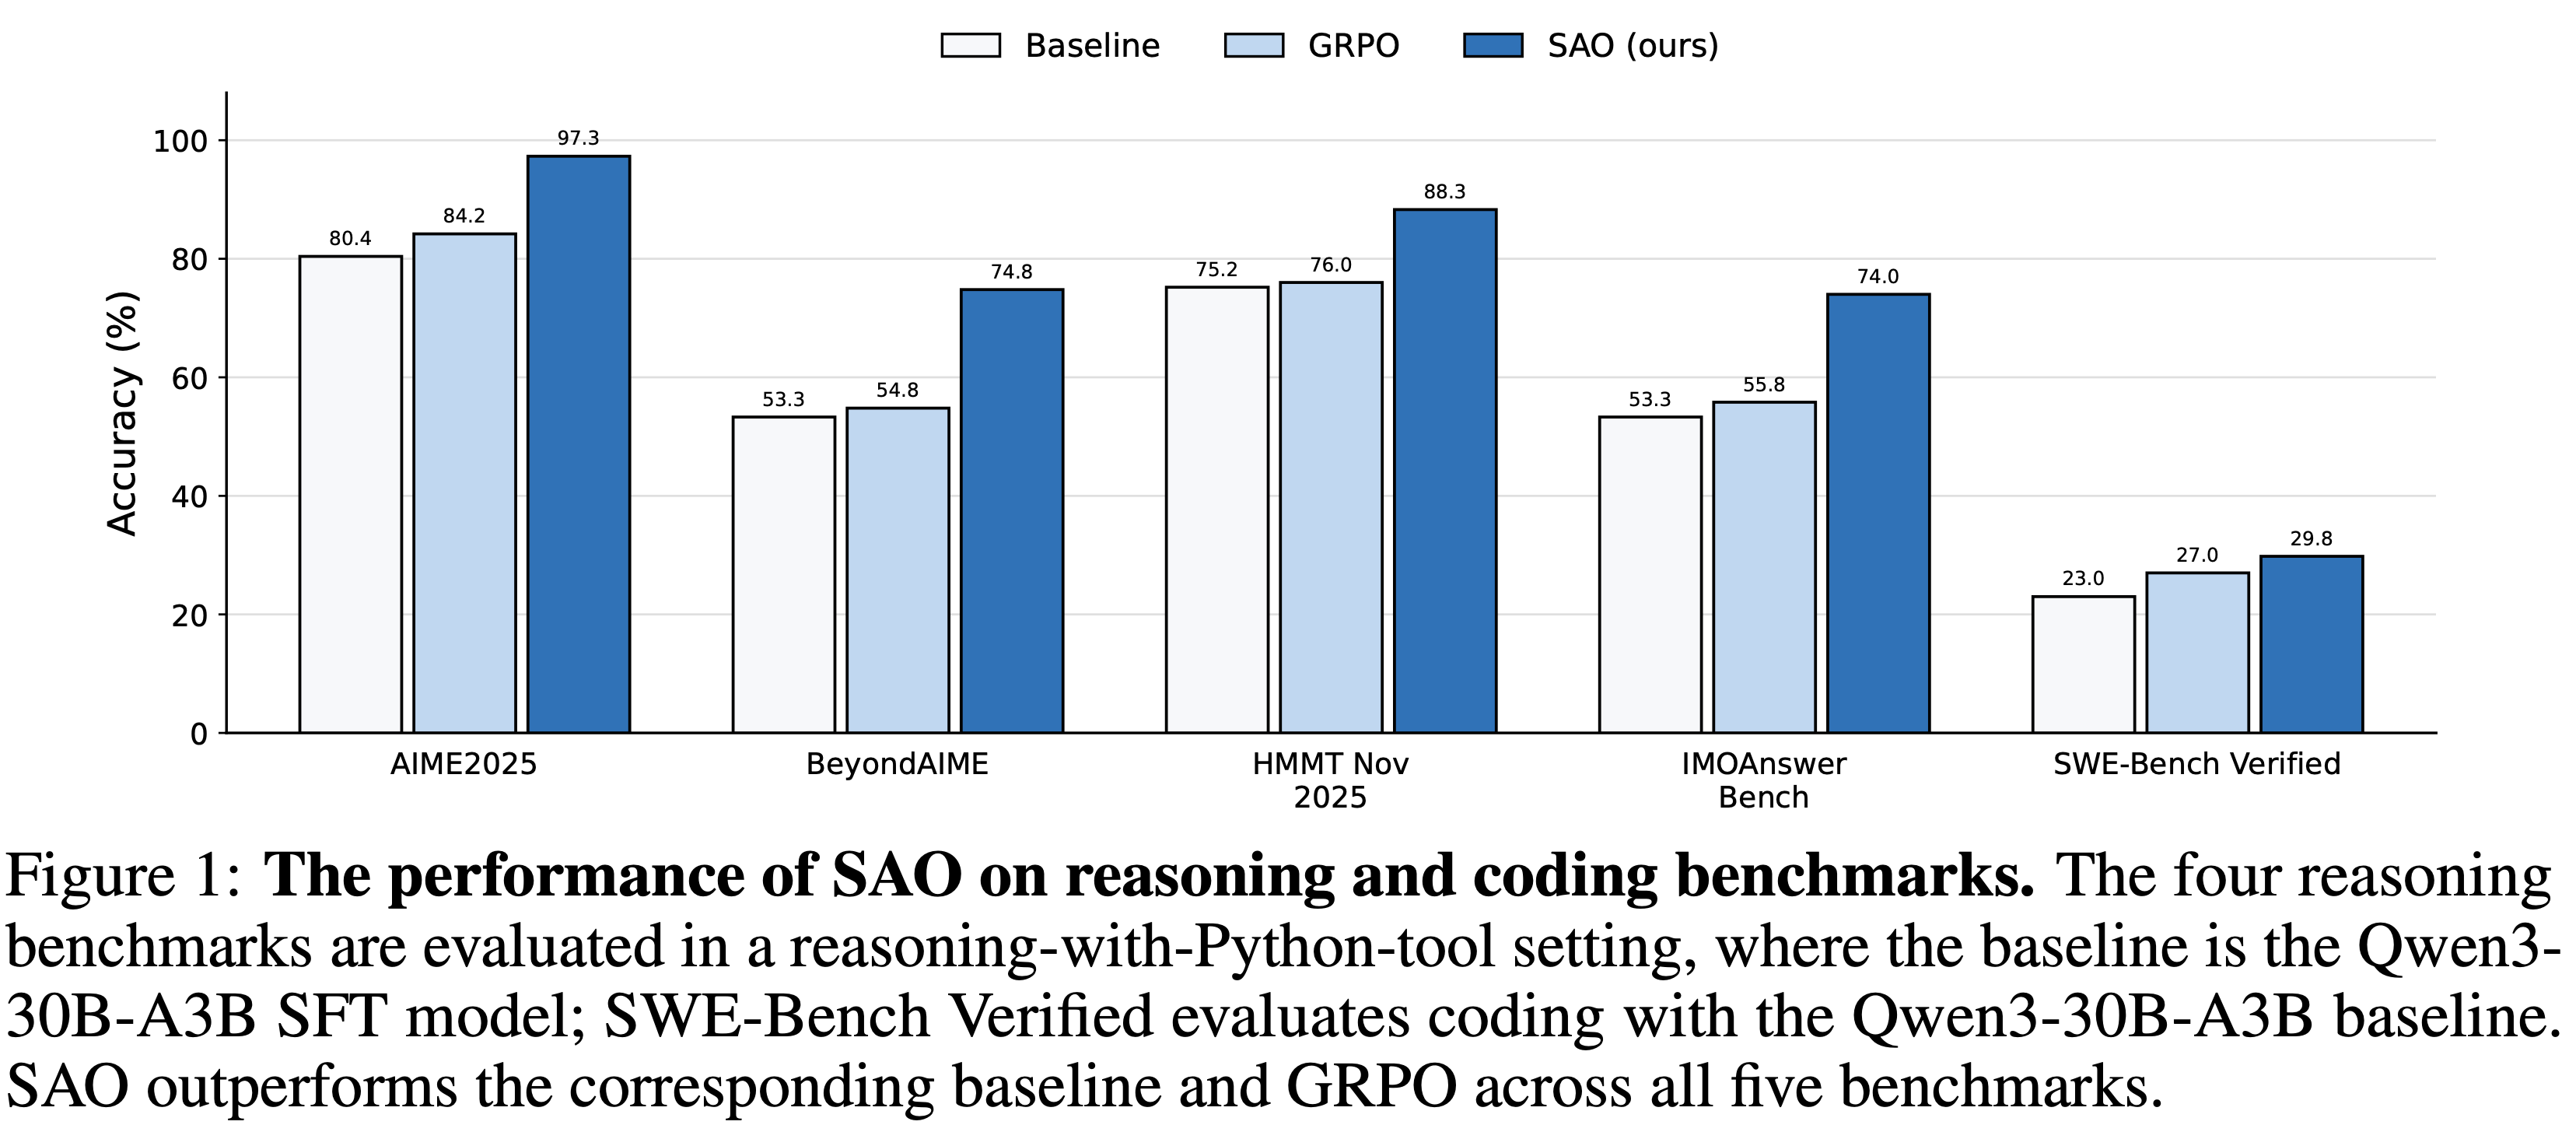
- SAO 在 SWE-Bench Verified、AIME2025、BeyondAIME 代码和数学推理榜单上,显著优于 Qwen3-30B-A3B 基线模型和 GRPO 变体,并且能稳定训练超过一千步
- PS:该技术已被成功部署于 GLM-5.2 (750B-A40B) 模型的训练中
- PS:该技术已被成功部署于 GLM-5.2 (750B-A40B) 模型的训练中
回顾:RL 中的 PPO 与 GRPO 对比
- RL 策略 \(\pi_\theta\) 根据问题 \(q\) 生成响应序列 \(y = [y_1,\ldots,y_{|y|}]\)
- 统一优化目标(带裁剪的替代目标函数):
$$
\mathbb{E}\left[\frac{1}{|y|}\sum_{t = 1}^{|y|}\min \left(r_t(\theta)\hat{A}_t,\text{clip}(r_t(\theta),1 - \epsilon ,1 + \epsilon)\hat{A}_t\right)\right]
$$- \(r_t(\theta) = \frac{\pi_{\theta}(y_{t}|q,y_{< t})}{\pi_{\theta_{\text{old} } }(y_{t}|q,y_{< t})}\) 是新旧策略的概率比
- \(\hat{A}_t\) 是 Advantage
- \(\epsilon\) 是裁剪超参数
- PPO :采用 Actor-Critic 架构
- 需要训练一个独立的Critic \(V_\phi\) 来估计状态价值,使用 GAE 计算优势:
$$
\hat{A}_t^{\text{GAE} } = \sum_{l = 0}^{|y| - t - 1}(\gamma \lambda)^l\delta_{t + l}
$$ - \(\delta_{t} = r_{t} + \gamma V_{\phi}(s_{t + 1}) - V_{\phi}(s_{t})\)
- PPO 的缺点是显存占用大(需要同时维护 Actor 和 Critic)
- 需要训练一个独立的Critic \(V_\phi\) 来估计状态价值,使用 GAE 计算优势:
- GRPO :为了省去 Critic 网络,GRPO 针对同一个 Prompt 采样一组 Responses,利用组内的相对奖励进行标准化来估计优势
- 但这种方法在异步训练中需要等待整组数据完成,违背了异步的初衷
Asynchronous Reinforcement Learning with Single Rollout
- 本节介绍 SAO 以解决异步 RL 训练中的训练不稳定性和 Off-policy 漂移
- SAO 告诉我们异步 RL 可以稳定地扩展到数千个训练步骤!
- 图 2 展示了 SAO 的整体设计
Stabilizing Asynchronous RL via Direct Double-Sided Importance Sampling (DIS)
- 本节描述如何通过 DIS 稳定 RL 训练
- 异步 RL 的一个主要挑战是 Rollout 模型与训练模型之间出现的“策略滞后(policy lag)”
- 在 Decoupled LLM PPO 中,采用重要性采样来缓解 Off-policy 偏差,通过维护三个不同的模型:
- 当前策略 \(\pi_{\theta}\)
- 旧策略 \(\pi_{\theta_{\text{old} } }\)
- Rollout 策略 \(\pi_{\text{rollout} }\)
- \(\frac{\pi_{\theta} }{\pi_{\theta_{\text{old} } } }\) 用于陈旧的 Off-policy 校正
- \(\frac{\pi_{\theta_{\text{old} } } }{\pi_{\text{rollout} } }\) 用于 Training-Rollout 不匹配
- 由于在异步 RL 中 Rollout 引擎可能在单个轨迹生成期间经历多次更新 ,这使得精确跟踪行为概率 \(\pi_{\theta_{\text{old} } }\) 在计算上变得不可行
- 否则必须维护大量的模型检查点历史 \(\{\pi_{\theta_{\text{old} } }^{(1)},\ldots ,\pi_{\theta_{\text{old} } }^{(N)}\}\),这在实际实现中是不可行的
- 问题:这个为什么不可行,直接将当时生成 Token 所使用的 logprobs 记录存下来就可以了吧,后续直接针对 Proximal 策略(old 策略)来重算一下 logprobs ,然后就可以使用 Decoupled PPO 方法
- 理解:这里应该是强调需要将采样轨迹所使用到的所有策略参数版本存下来,用于训练引擎回放 Rollout 策略(理论上可行,但是版本太多时现实中没人会这么做,因为要存储的模型版本数量太多了,训练引擎 forward 计算时需要跨越多个模型也会很复杂)
- 在 Decoupled LLM PPO 中,采用重要性采样来缓解 Off-policy 偏差,通过维护三个不同的模型:
- SAO 提出了一种简化但激进的 Token 级重要性采样来裁剪 Off-policy Token
- 首先,直接使用 \(\pi_{\text{rollout} }\) 作为 Behavior proxy,并使用 \(\pi_{\theta}\) 进行重要性采样,即
$$ r_{t}(\theta) = \frac{\pi_{\theta} }{\pi_{\text{rollout} } }$$- 这放弃了不准确的 \(\pi_{\theta_{\text{old} } }\)
- 注:这消除了单独旧策略推理的计算开销,通过利用 Rollout 阶段生成的对数概率
- 理解:本质就是 VeRL 中的 Bypass 模式
- 其次,采用了一种双侧校准 Token 级掩码策略(double-sided calibration token-level masking strategy)
- 标准 PPO 裁剪:仅裁剪满足 \((A > 0,r_{t}(\theta) > 1 + \epsilon_{h})\) 或 \((A< 0,r_{t}(\theta)< 1 - \epsilon_{t})\) 的选定 Off-policy Token
- SAO 裁剪:限定在 \([1 - \epsilon_{t},1 + \epsilon_{h}]\) 内
- 落在此范围之外的 Token 将完全从梯度计算中掩码掉,以防止极端策略分歧引起的不稳定性
- 理解:
- 原始 PPO 的本意是使得迭代的步长不要太大,时 Trust Region 更新的思想;
- 当前这种两边都 mask 的策略本质是因为此时的 IS 中包含了训推不一致信号,是为了防止训推不一致导致的一些异常信号而做的两边都 Clip/mask
- 注:SAO 这个做法这与 IcePop 机制(2025)有相似之处,但本文的策略更简单,进一步去除了 \(\pi_{\theta_{\text{old} } }\),同时仍能实现稳定训练
- 首先,直接使用 \(\pi_{\text{rollout} }\) 作为 Behavior proxy,并使用 \(\pi_{\theta}\) 进行重要性采样,即
- 形式上,带有 Token 级裁剪的优化目标可写为:
$$
L(\theta) = \hat{\mathbb{E} }_{t}\left[\color{red}{f}(\color{blue}{r_{t}(\theta)},\epsilon_{t},\epsilon_{h})\hat{A}_{t}\log \pi_{\theta}(a_{t}|s_{t})\right] \tag {1}
$$- SAO 目标解读1:概率比 \(\color{blue}{r_{t}(\theta)}\) 直接从 Rollout 日志计算,不需要跟踪历史策略版本:
$$
\color{blue}{r_{t}(\theta)} = \exp \left(\log \pi_{\theta}(a_{t}|s_{t}) - \log \pi_{\text{rollout} }(a_{t}|s_{t})\right) \tag {2}
$$ - SAO 目标解读2:通过校准函数 \(\color{red}{f(x; \epsilon_{t}, \epsilon_{h})}\) 进一步强制稳定性:
$$
\color{red}{f(x;\epsilon_{t},\epsilon_{h})} = \begin{cases} \begin{array}{ll}x, & \text{if } 1 - \epsilon_{t}< x< 1 + \epsilon_{h}\\ 0, & \text{otherwise} \end{array} \end{cases} \tag {3}
$$
- SAO 目标解读1:概率比 \(\color{blue}{r_{t}(\theta)}\) 直接从 Rollout 日志计算,不需要跟踪历史策略版本:
- 这种设计避开了跟踪历史策略的需求
- 直接使用 Rollout 对数概率,接受了一定程度的 Off-policy 偏差,以换取计算复杂度的显著降低,并消除了使用单个、可能陈旧的“最新”旧策略模型所带来的误差
- 理解1:用不用 Rollout 对数概率都要接受这个 Off-policy 偏差的,只是说在重计算 Proximal Policy 时,PPO Clip Ratio 系数中没有这个 Off-policy 偏差
- 理解2:Proximal Policy 一般就是这里所说的 单个、可能陈旧的“最新”旧策略模型
- 实证结果表明,这种简化机制支持更激进的裁剪,从而有效地正则化更新步骤,并在异步设置中产生优越的训练稳定性
- 直接使用 Rollout 对数概率,接受了一定程度的 Off-policy 偏差,以换取计算复杂度的显著降低,并消除了使用单个、可能陈旧的“最新”旧策略模型所带来的误差
- 问题:不重新计算 \(\pi_{\theta_\text{old}}\) 会导致我们的无法计算训推不一致的情况,可以考虑单独计算一些策略相同,引擎不同的值来作为监控
Reducing Off-Policy with Single Rollout
- 在异步 RL 中,Off-policy 是一个不可避免的问题,但当前流行的组式采样 RL 算法(例如 GRPO)可能会引入更严重的 Off-policy
- 组式采样引入了“不均衡生成”偏差,并且组数据必须等待“最慢”的样本完成才能送入训练
- 一个有前景的解决方案是用单 Rollout 替代组式采样
- 即样本一旦生成就立即送入训练
- 但单 Rollout 优化本质上存在梯度估计的高方差问题,类似于 REINFORCE(2021)
- 为了降低方差,需要足够好的 Value-model
- 本节专注于简单策略来优化 Value-model,最终提升策略的性能
Faster Value Update than Policy,更快的 Critic 更新
- 作者认为出单 Rollout RL 中不稳定的主要来源是策略与价值函数之间的相互依赖
- 如果 Value-model \(V_{\phi}\) 不准确,则优势估计 \(\hat{A}_{t}\) 会带有噪声,导致破坏性的策略更新
- 为了缓解这一问题,实现了适用于 LLM 的更快 Value 更新
- 将策略和价值模型的优化频率解耦
- 具体做法:
- 对于应用于策略 \(\pi_{\theta}\) 的每一次梯度更新,对价值网络 \(V_{\phi}\) 执行 \(K\) 次更新(其中 \(K > 1\))
- 在实验中,设置 \(K = 2\)
- 该策略有助于在价值估计用于优势计算之前更快地适应当前策略,从而降低方差
- 对于应用于策略 \(\pi_{\theta}\) 的每一次梯度更新,对价值网络 \(V_{\phi}\) 执行 \(K\) 次更新(其中 \(K > 1\))
- 理解:这里的做法其实是传统 RL 中常用的方法
Stabilizing Value Model Training via Parameter Freezing,参数冻结稳定 Critic 训练
- 作者初步实验发现 Value-model 训练的不稳定性,其中 Value-model 的梯度范数显著大于相应的 Policy-model
- 进一步分解表明,这种不稳定性 主要源于 Full Attention layers ,而 MoE 层保持相对稳定
- 解法:为 Value-model 采用 “Frozen-Attention” 训练策略
- 在 RL 训练期间,冻结 \(V_{\phi}\) 中注意力模块的参数,并优化 MoE Projections
- 思想:认为预训练的注意力权重已经具备足够的语义能力来关注相关 Token
- 通过将优化限制在 MoE 层,有效地正则化了 Value-model
Skip-Observation Token-level GAE for Agentic Tasks,跳过观测 Token 级 GAE
- Agentic 任务由于其轨迹结构对 Token 级价值估计提出了独特挑战:
$$ T = [a_0,o_0,a_1,o_1,\ldots ]$$- \(a_{i}\) 表示模型动作
- \(o_{i}\) 表示环境反馈
- 标准的 GAE 会计算相邻 Token 之间的价值差异
- 但从模型的角度来看,从动作 \(a_{i,\text{end} }\) 的结束到观测 \(o_{i,\text{start} }\) 的开始之间的转换是不连续的,因为模型不生成 \(o_{i}\)
- 跨此边界计算优势会引入噪声,因为 Value-model \(V(o_{i,\text{start} })\) 试图预测外部环境状态的价值
- 解法:推导出一种 “Skip-Observation” GAE
- 显式地修改 Bellman 目标以绕过环境反馈 Token,将当前动作的价值直接连接到后续动作的价值
- 形式上,令 \(a_{i,N}\) 为动作 \(i\) 的最后一个 Token,\(a_{i + 1,0}\) 为下一个动作的第一个 Token
- 将优势定义为:
$$
\hat{A} (a_{i,N}) = \delta +\gamma \lambda \hat{A} (a_{i + 1,0}) \tag {4}
$$- 其中时序差分残差 \(\delta\) 跨观测间隙计算:
$$
\delta = r_t + \gamma V(a_{i + 1,0}) - V(a_{i,N}) \tag {5}
$$ - 该公式将优势估计约束为纯粹依赖于模型输出,过滤掉环境反馈的随机性
- 其中时序差分残差 \(\delta\) 跨观测间隙计算:
- 一些工作可能考虑使用 Step-level Critic 和 GAE 作为 Token 级价值的替代
- 但作者发现 Step-level Critic 可能导致次优性能(在实验部分有细节)
- 注:作者还对 Agentic 轨迹进行了其他优势设计,结果可在附录中找到
Scaling Value Pretraining
- 作者还发现扩大用于 Value-model 预训练的数据规模对支持上述机制至关重要
- 实验表明,价值估计中的“冷启动”问题是一个主要瓶颈
- 显著增加 Value 预训练语料库的规模,可提供了一个稳健的初始化点,从而从训练早期就促进了单 Rollout 和 TTUR 机制的有效性
- 理解:这里说的 TTUR mechanisms 应该是 “Two Time-scale Update Rule”(双时间尺度更新规则,简称 TTUR),RL 中特指 Critic 和 Actor 更新 次数/步长/学习率 不同
- GANs 领域也常用这个词表达类似含义(Generator 和 Discriminator 更新 次数/步长/学习率 不同)
实验
实验设置
- Base Model :Qwen3-30B-A3B-Thinking-2507
- 领域:数学推理(Python 工具集成,TIR)和代码修复(SWE-Bench Verified,使用 OpenHands 框架)
- Baselines :
- GRPO :标准实现(带 Clip-higher)
- GRPO (w/ DIS) :将 SAO 提出的重要性采样策略应用到 GRPO 中(作为强基线)
- VAPO :标准 VAPO 采用长度自适应的 GAE 和基于价值的 RL 基线
- single-rollout with Running-mean baseline :为每个 Prompt 维护最近 8 个奖励的滑动窗口,使用其均值作为基线进行优势估计,
- 作为参数化 Critic 模型的替代方案
- 训练细节 & 超参数:
- Python 数学推理 SFT(后续作为 初始策略和 Critic 模型):
- 基础模型:Qwen3-30B-A3B-Thinking-2507
- 微调 Epochs:3
- 训练数据:Tool-Integrated Reasoning (TIR) 数据(由 GPT-OSS-120B 生成)
- Agentic 推理 RL 训练(主要 SAO 设置)
- batch size:128
- group size,即每个 prompt 的 rollout 数量:1
- 最大生成长度(max-length):128k tokens
- policy LR:\(1 \times 10^{-6}\)
- Token 裁剪下限(\(\epsilon_{\text{low} }\)):0.3
- Token 裁剪上限(\(\epsilon_{\text{high} }\)):5.0
- 长度自适应 GAE 的 \(\lambda_{\text{policy} }\):\(\lambda_{\text{policy} } = 1 - \frac{1}{\alpha l}\)
- 其中 \(\alpha = 1.5\)
- value model LR:\(5 \times 10^{-6}\)
- 价值模型 GAE 的 \(\lambda_{\text{critic} }\):1
- 价值模型预热步数(warmup steps):10
- 每批次价值模型更新次数(\(K\),即 faster value update):2(即每批次对价值模型进行 2 次更新)
- GRPO 变体(对比实验)
- 每批次 prompt 数量:16
- 每个 prompt 的 rollout 样本数:8
- 总批次大小:128(与 SAO 相同)
- Coding Agent RL 训练(与 TIR 超参数基本一致,仅裁剪参数不同)
- Token 裁剪下限(\(\epsilon_{\text{low} }\)):0.8
- Token 裁剪上限(\(\epsilon_{\text{high} }\)):3.0
- SWE-Bench Verified 评估设置
- 最大交互轮次(interaction turns):300
- 上下文预算(context budget):128k tokens
- Python 数学推理 SFT(后续作为 初始策略和 Critic 模型):
Main Results
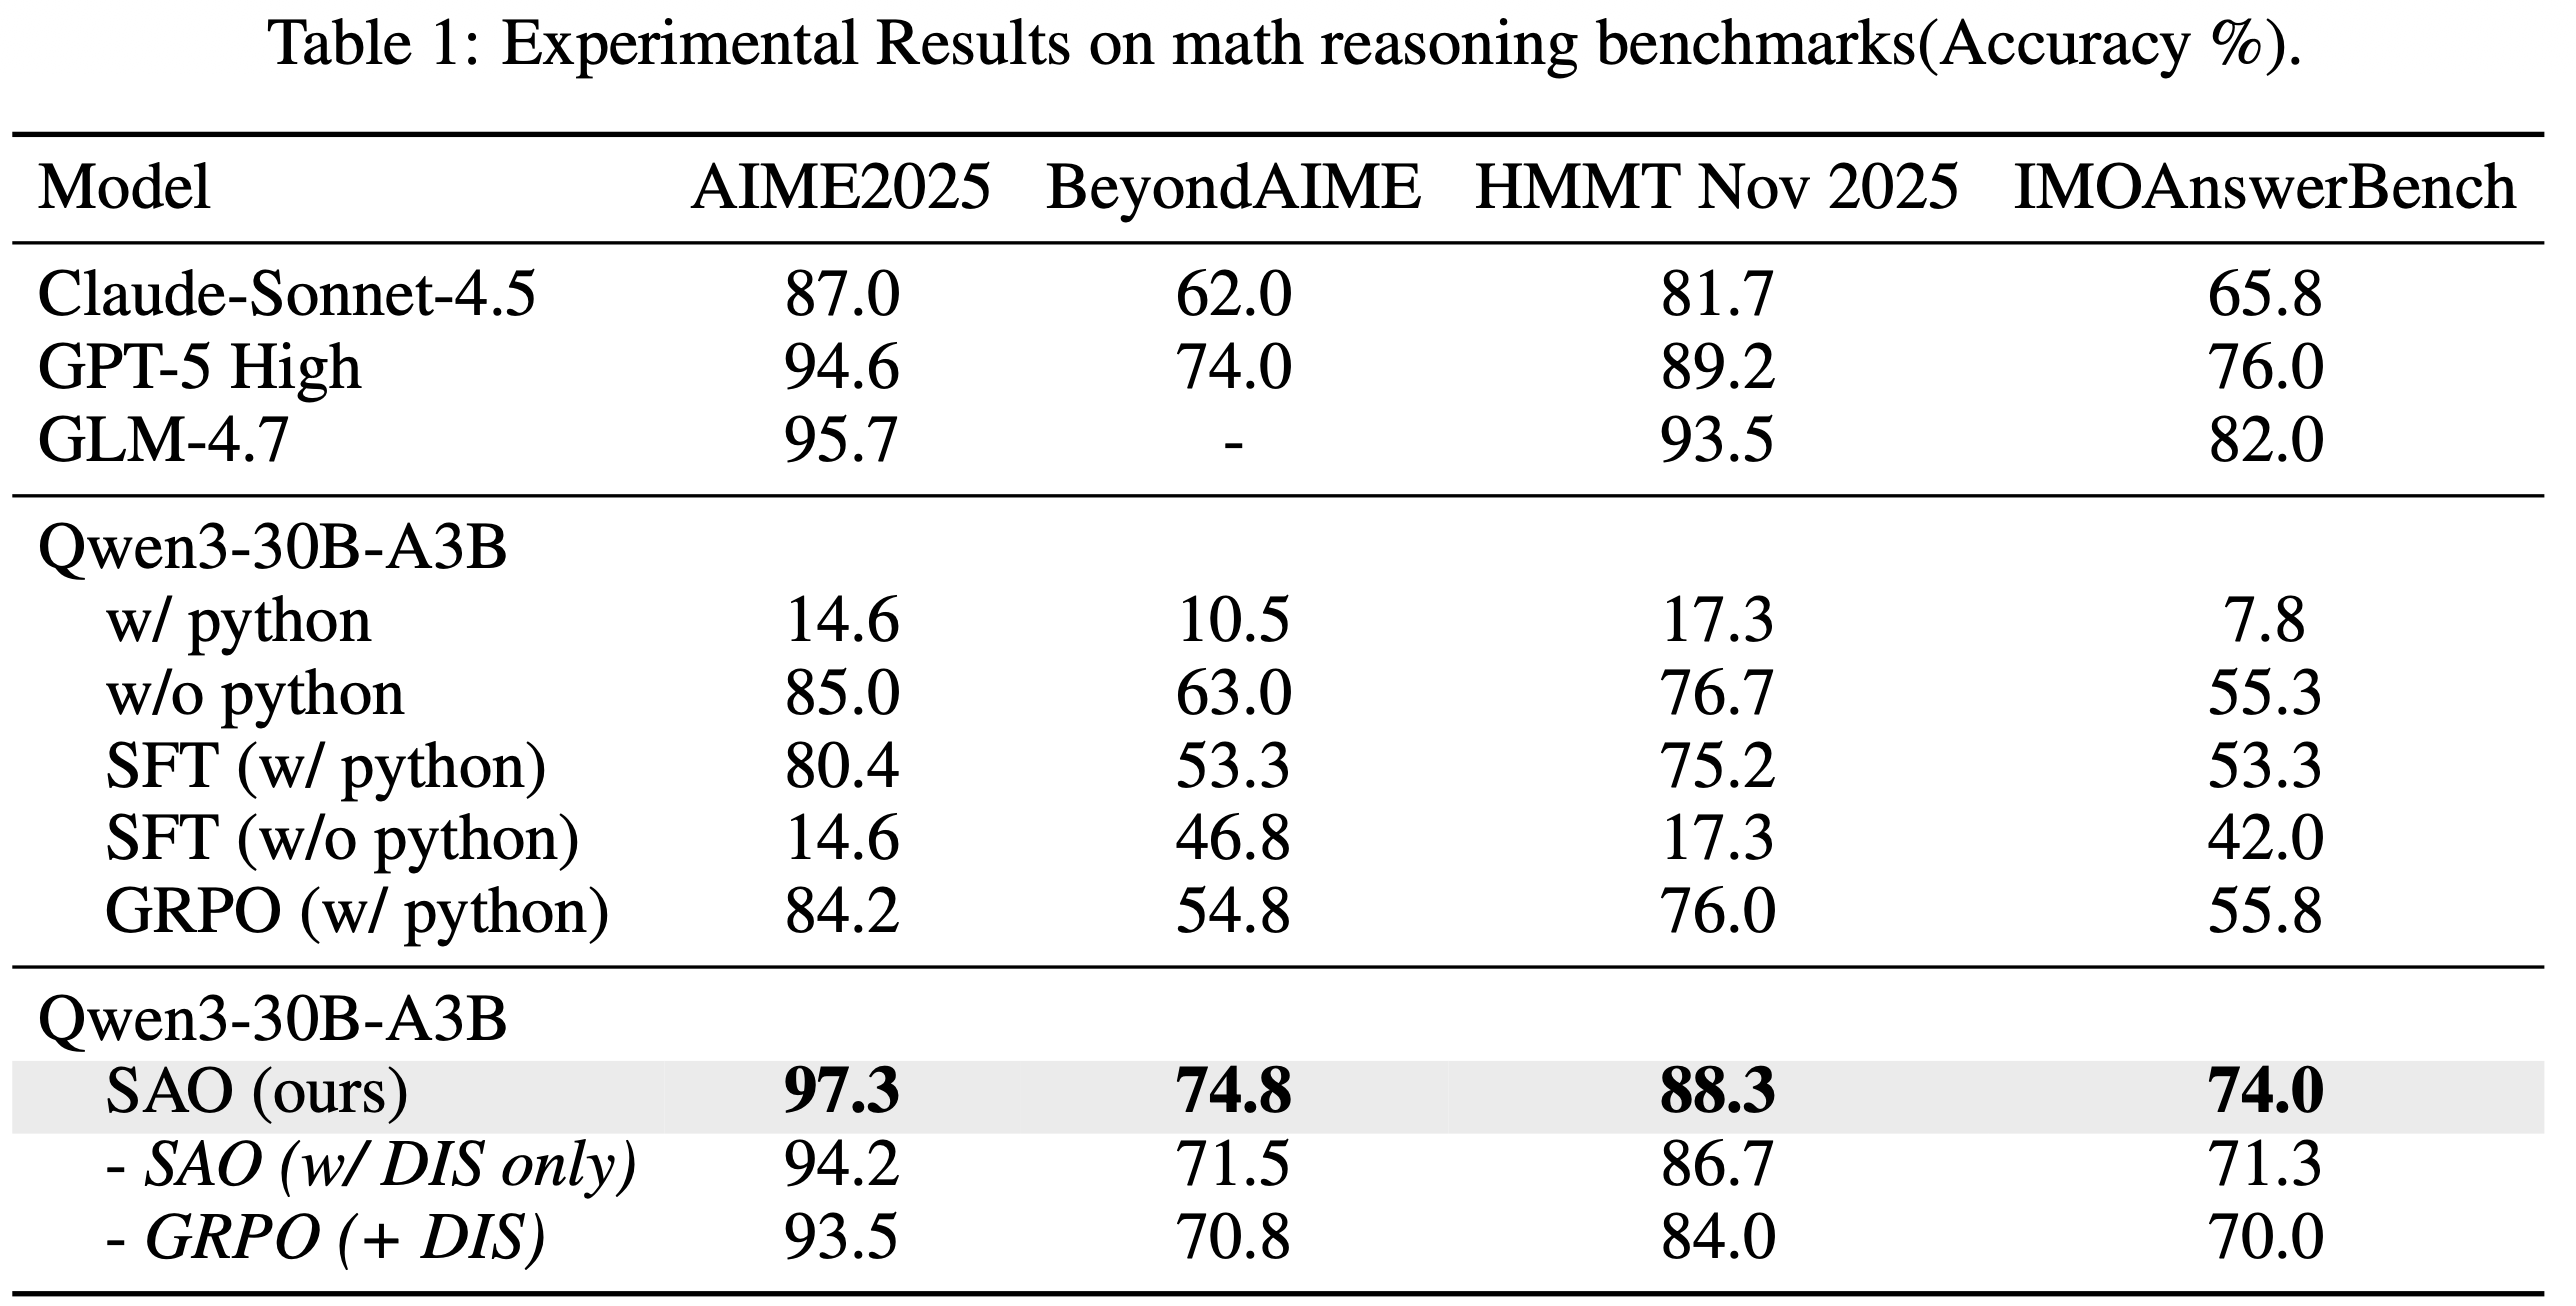
- Table 1 (数学推理) :SAO 在 AIME2025 达到 97.3% ,BeyondAIME 达到 74.8% ,显著超越 SFT 基线和 GRPO(注:GRPO 使用的是 clip-higher)
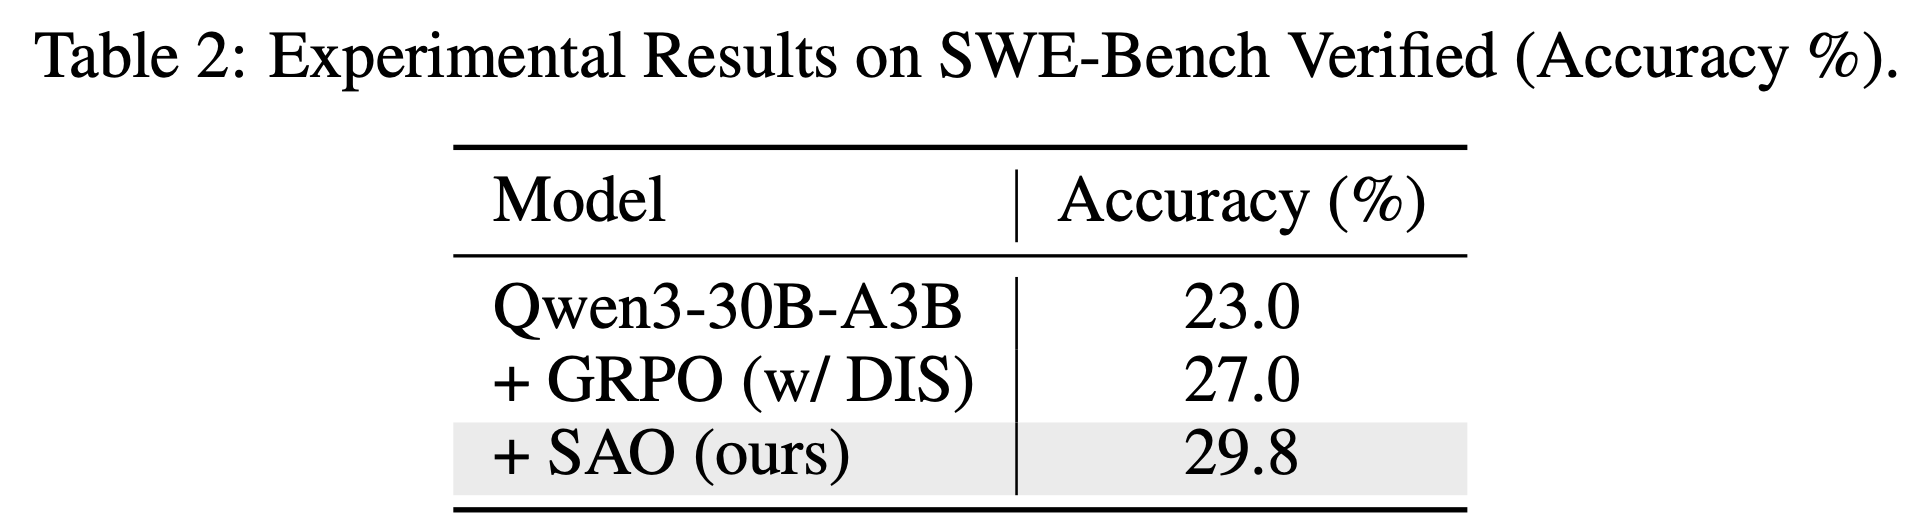
- Table 2 (代码生成) :在 SWE-Bench Verified 上,SAO 准确率为 29.8% ,高于 GRPO(27.0%)和基础模型(23.0%)
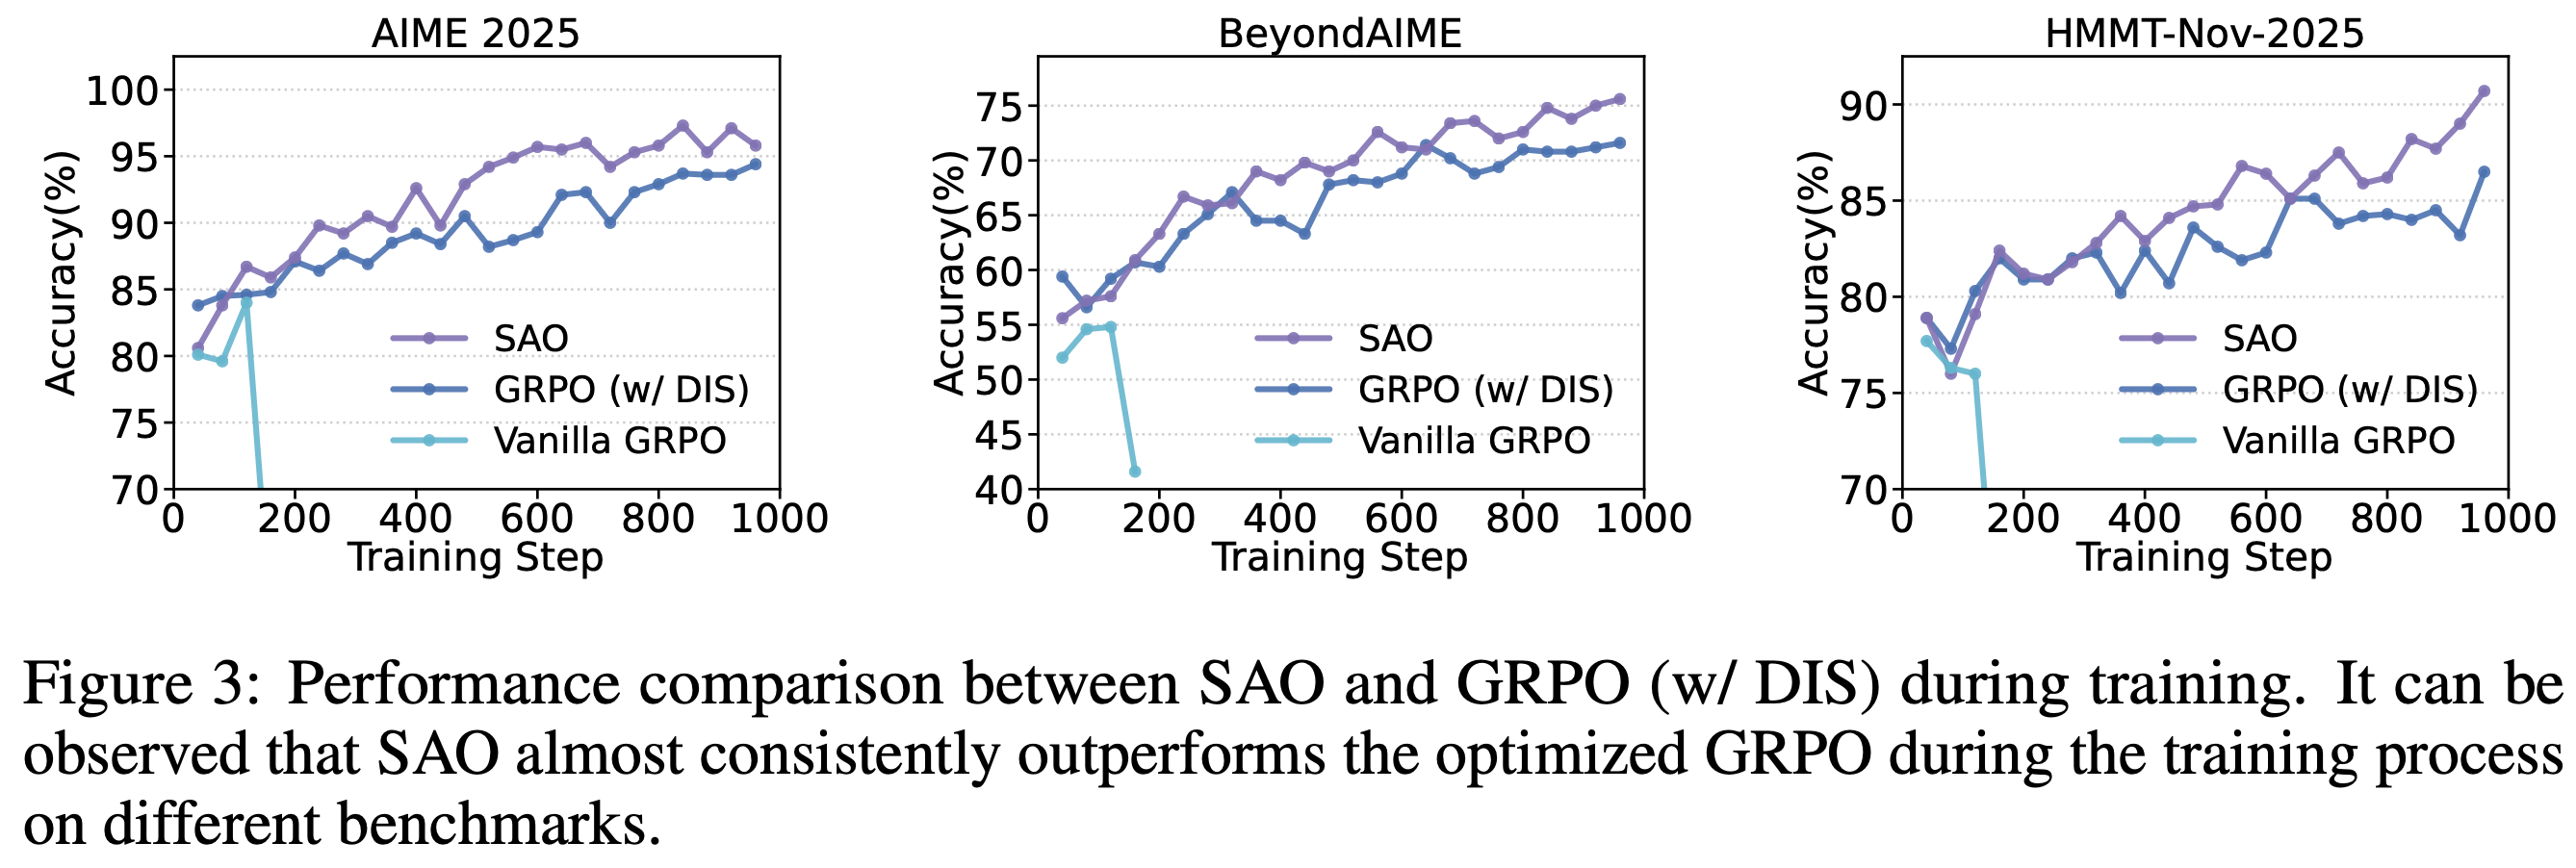
- 训练稳定性 :GRPO 在约 160 步后会发生性能崩溃,而 SAO 可稳定训练至 1000 步以上,且收益持续增长(图 3)
Ablations
- 消融结果见表 3 和 表 4
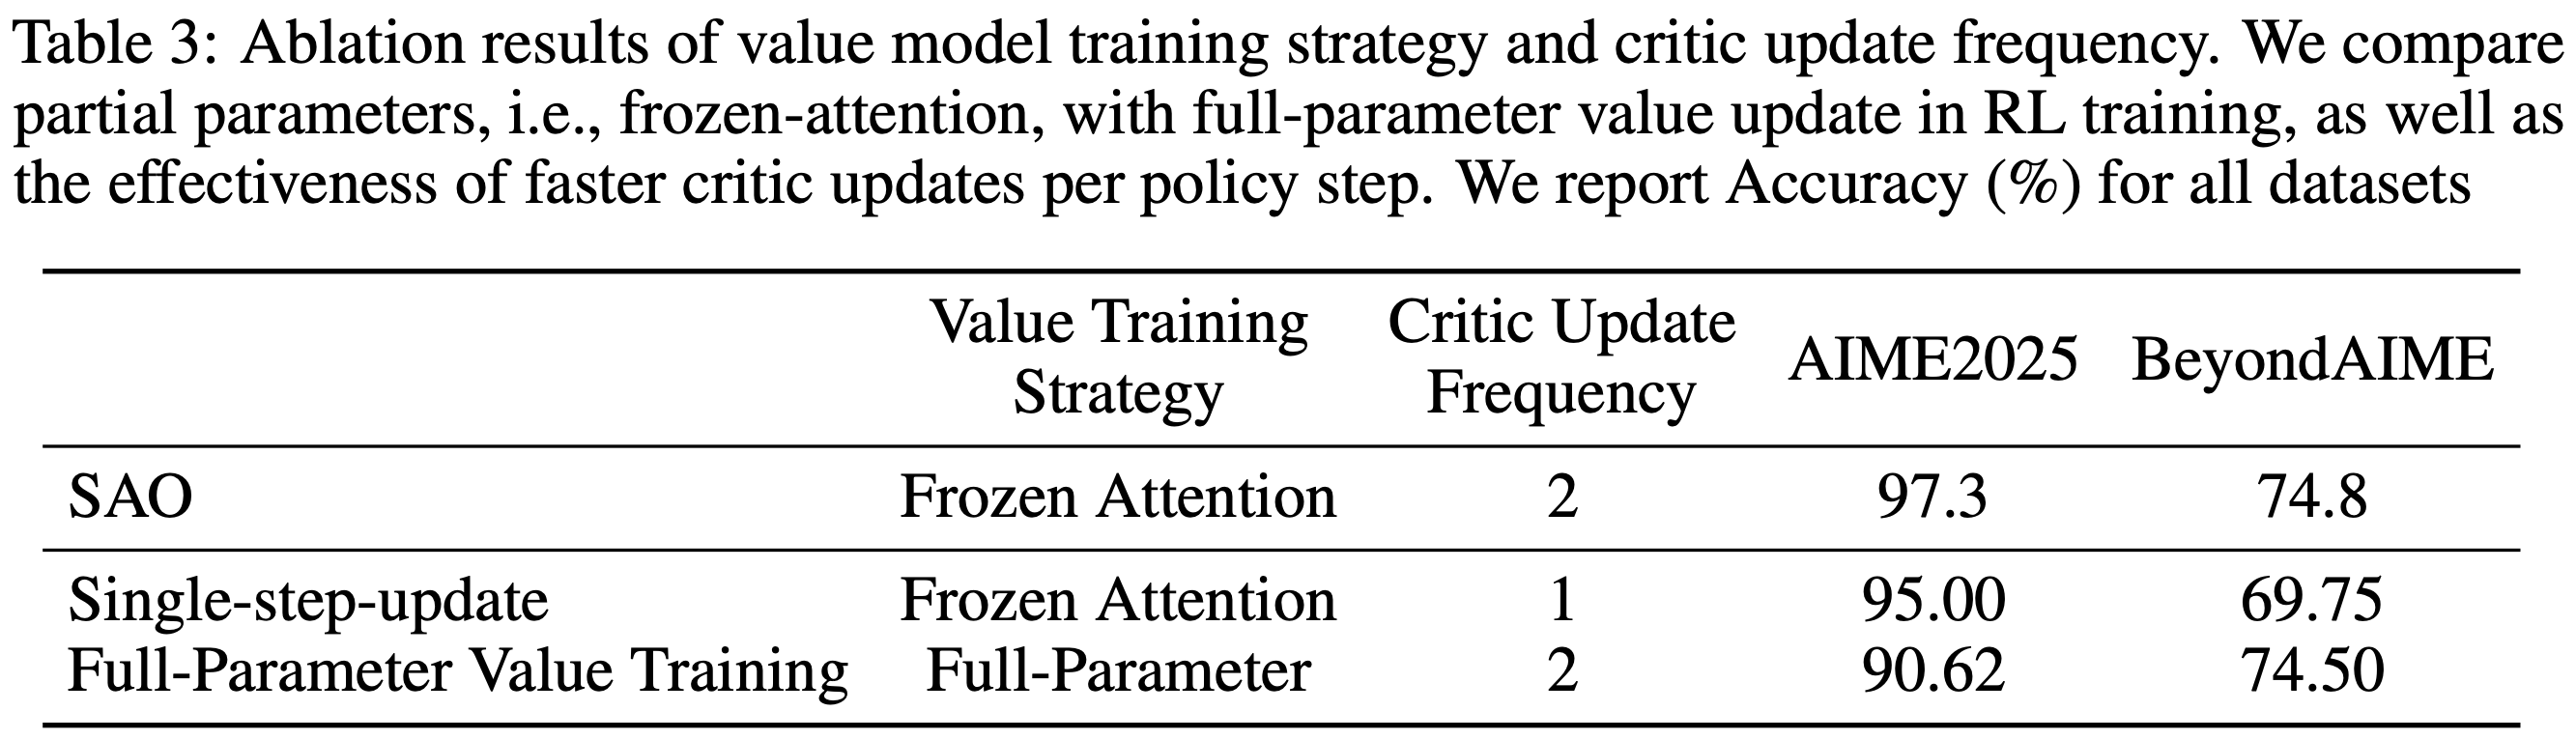
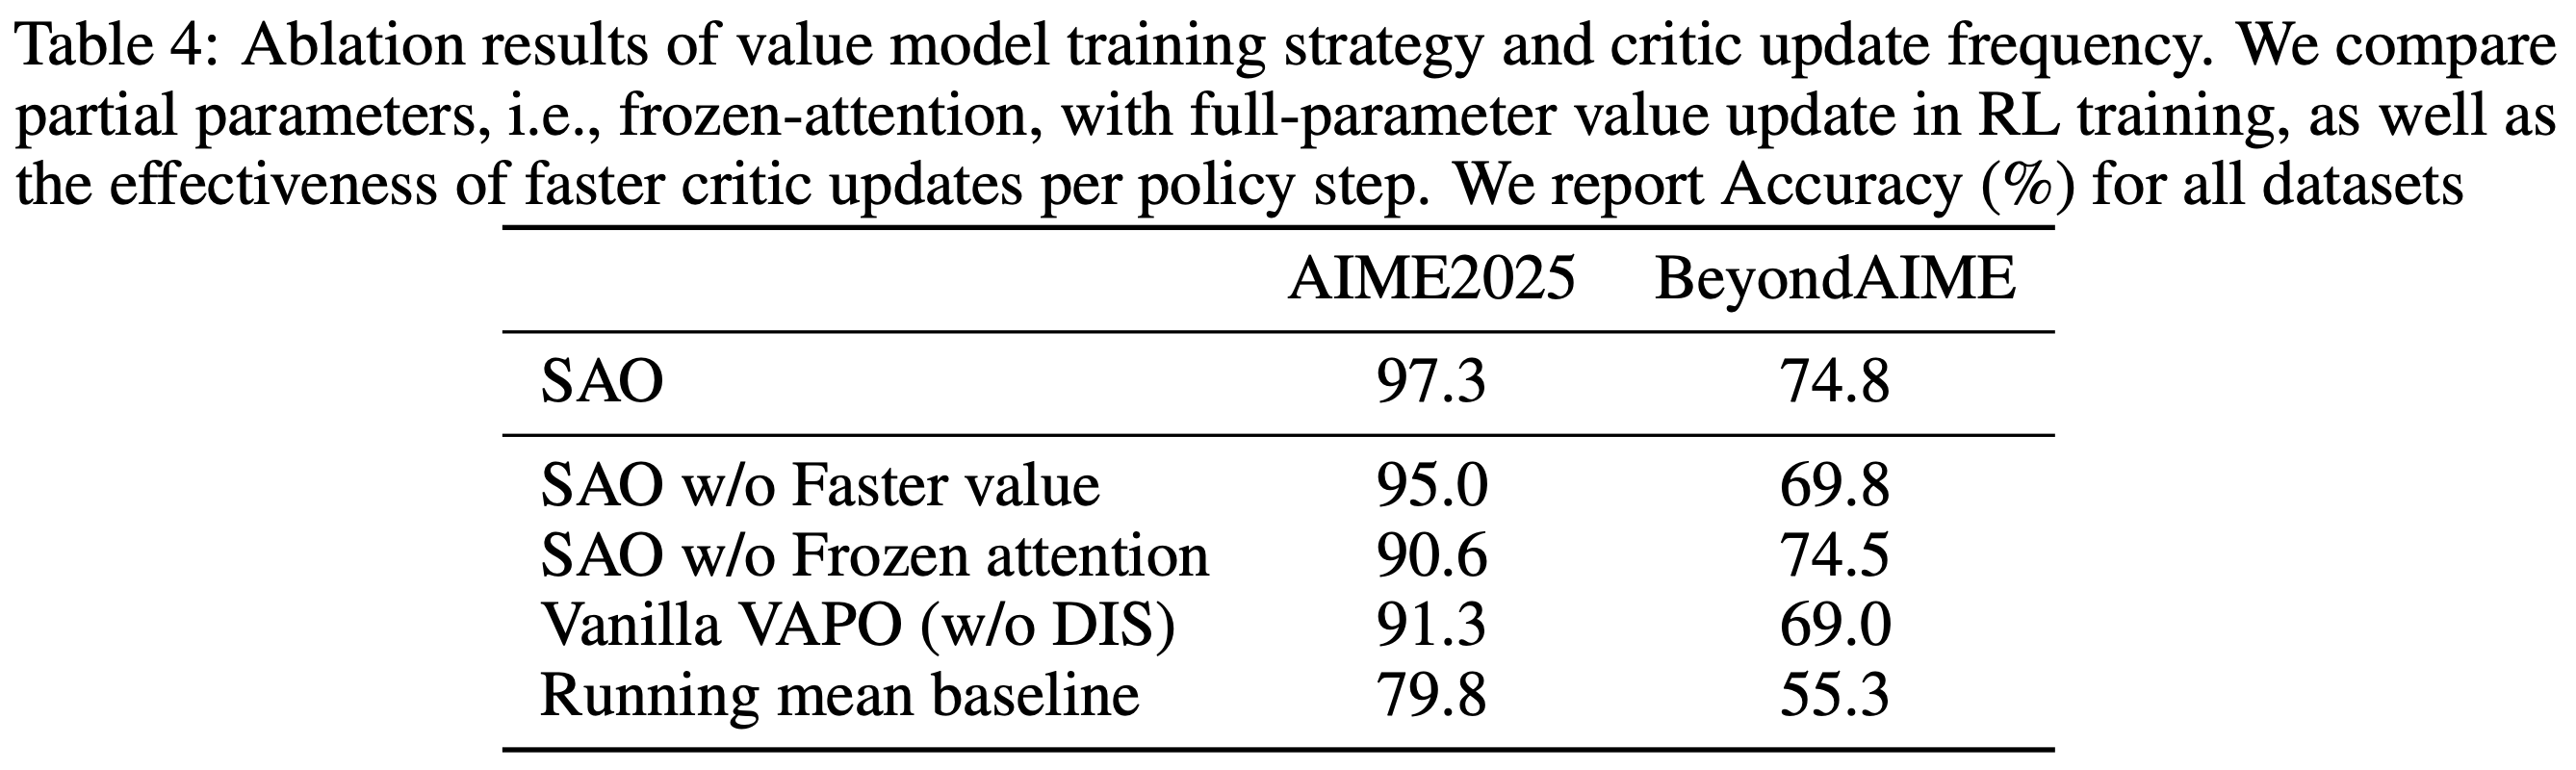
- 价值更新频率 :若不使用 Faster Value(Critic 只更新 1 次),AIME 准确率从 97.3% 降至 95.0%
- 证明 Critic 需要更快的频率以匹配 Actor 的变化
- Frozen-Attention :若放开 Full-Parameter 更新(不冻结 Attention),准确率降至 90.6%
- 证明了冻结策略的正则化有效性
- DIS 机制 :去除 DIS(使用 Vanilla VAPO),训练会迅速崩溃
- 证明了直接双边裁剪在异步场景下的必要性
- Running Mean 基线 :仅使用滑动窗口平均奖励作为基线,效果远差于 SAO(79.8% vs 97.3%)
- 证明了可学习价值模型的必要性
Training Dynamics
- 训练动态详情见 图 4
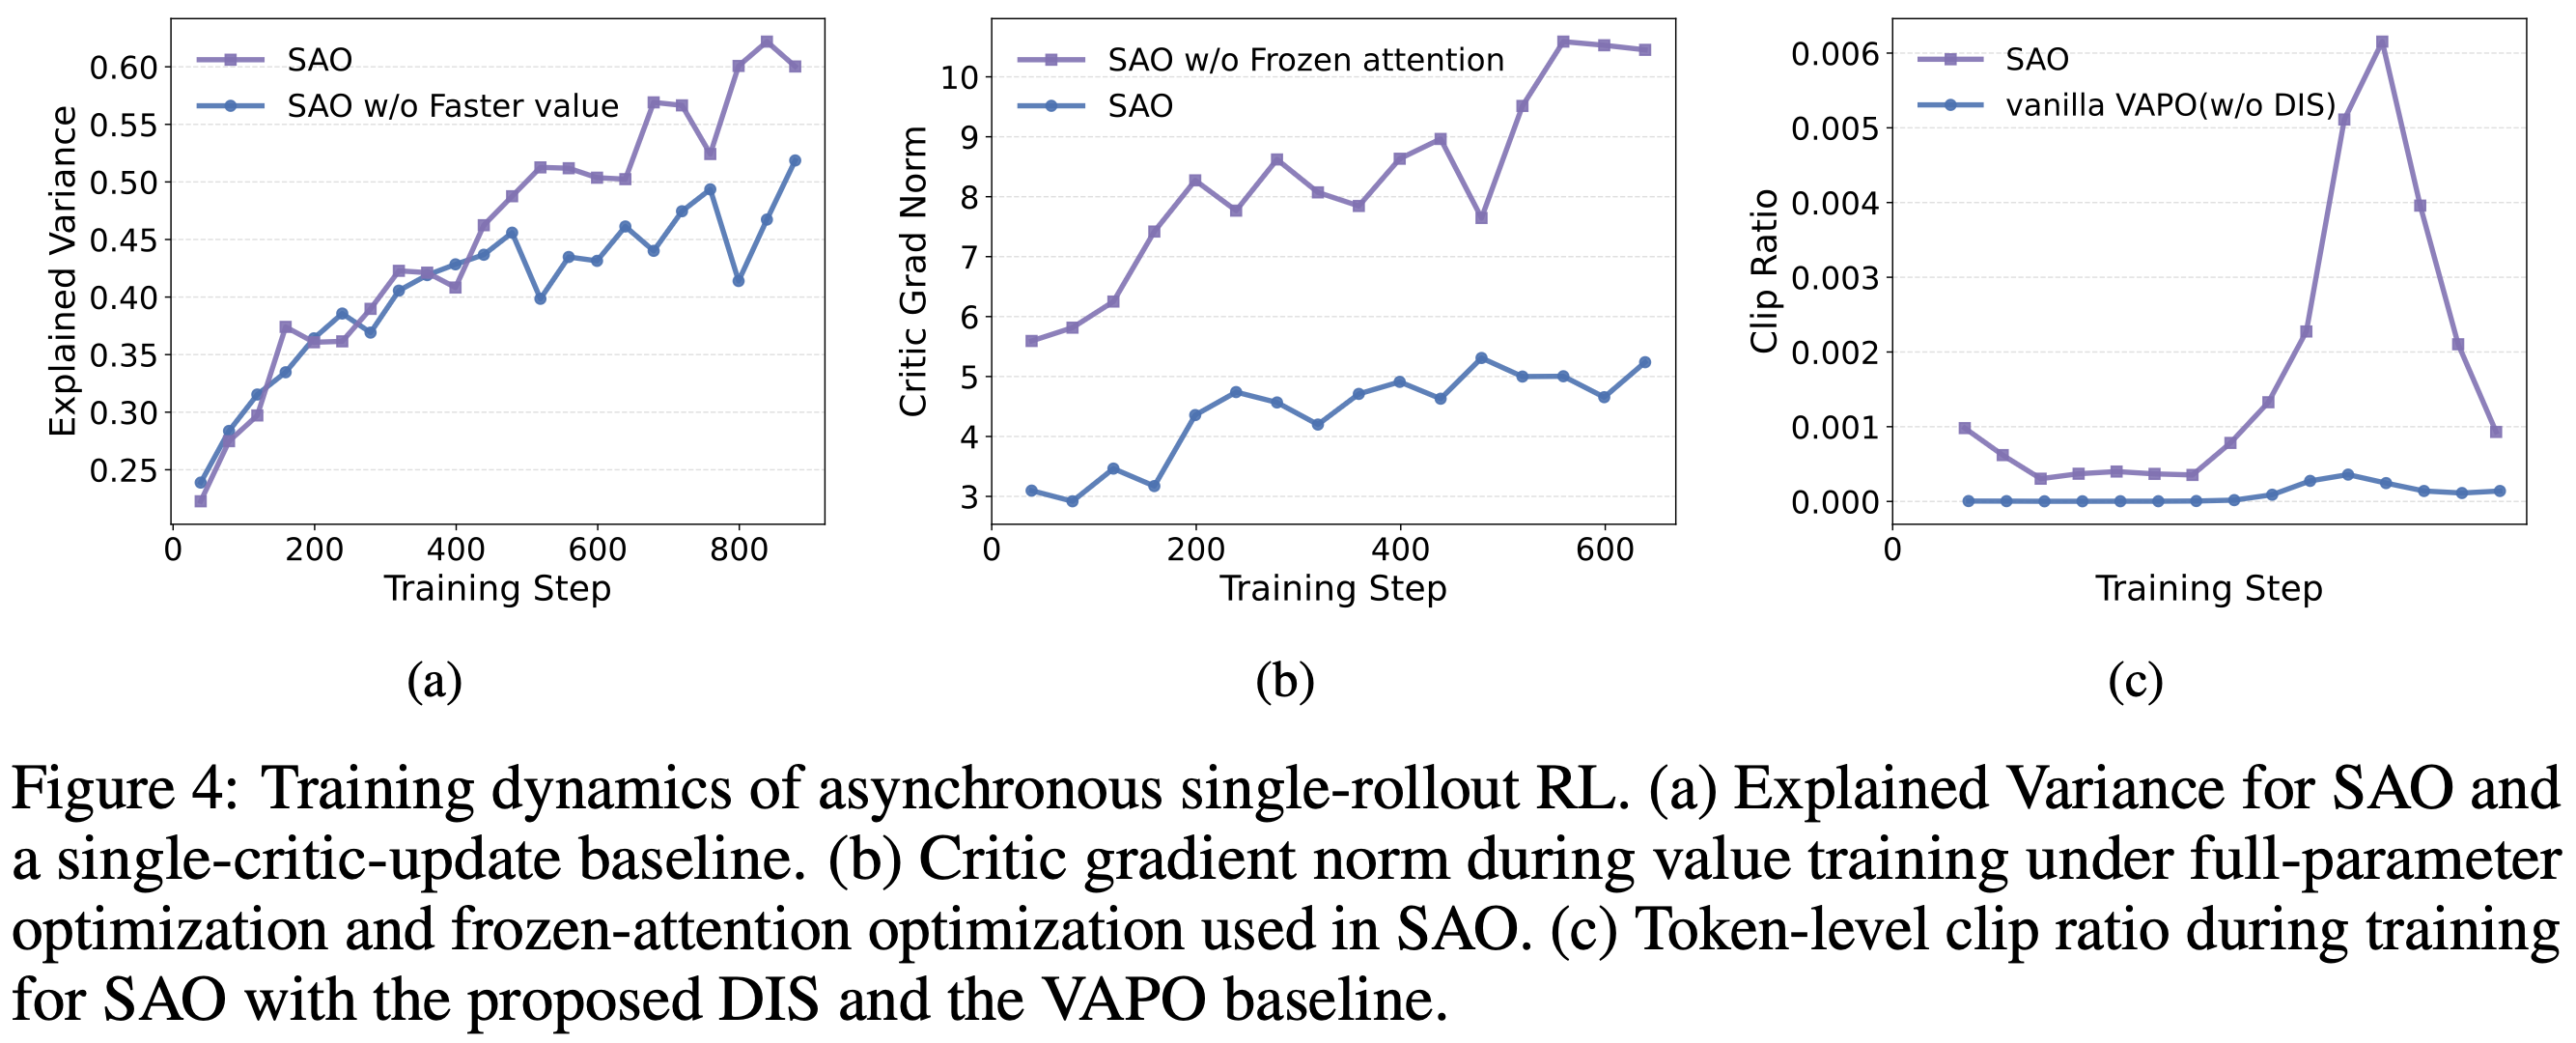
- Explain Variance (图 4a) :SAO 的价值模型在 400 步后拥有远高于单步更新基线的解释方差,说明价值估计更准
- 注:解释方差 (Explained Variance) 衡量预测值 \(V(s)\) 与真实回报 \(R\) 之间的一致性,定义为
$$ EV = 1 - \frac{\text{Var}(R - V(s))}{\text{Var}(R)}$$
- 注:解释方差 (Explained Variance) 衡量预测值 \(V(s)\) 与真实回报 \(R\) 之间的一致性,定义为
- Grad Norm (图 4b) :Full-parameter 更新的 Critic 梯度范数巨大且震荡,Frozen-Attention 则平滑收敛
- Clip Ratio (图 4c) :
- VAPO 裁剪率接近 0,但由于未有效应对 Off-policy 扩散,在 90 步崩溃
- SAO 保持了健康的裁剪率并稳定收敛
Online Learning Simulation(有趣的实验)
- Task Design
- 在现实世界的在线学习环境中,反馈通常限制为每个 Prompt 单条轨迹
- 这一约束天然与基于组的优化策略(如 GRPO)不兼容,因为 GRPO 依赖样本组内的相对奖励进行优势估计
- SAO 利用基于价值的 Critic 提供优势估计,从而能够从单条轨迹进行有效的策略更新
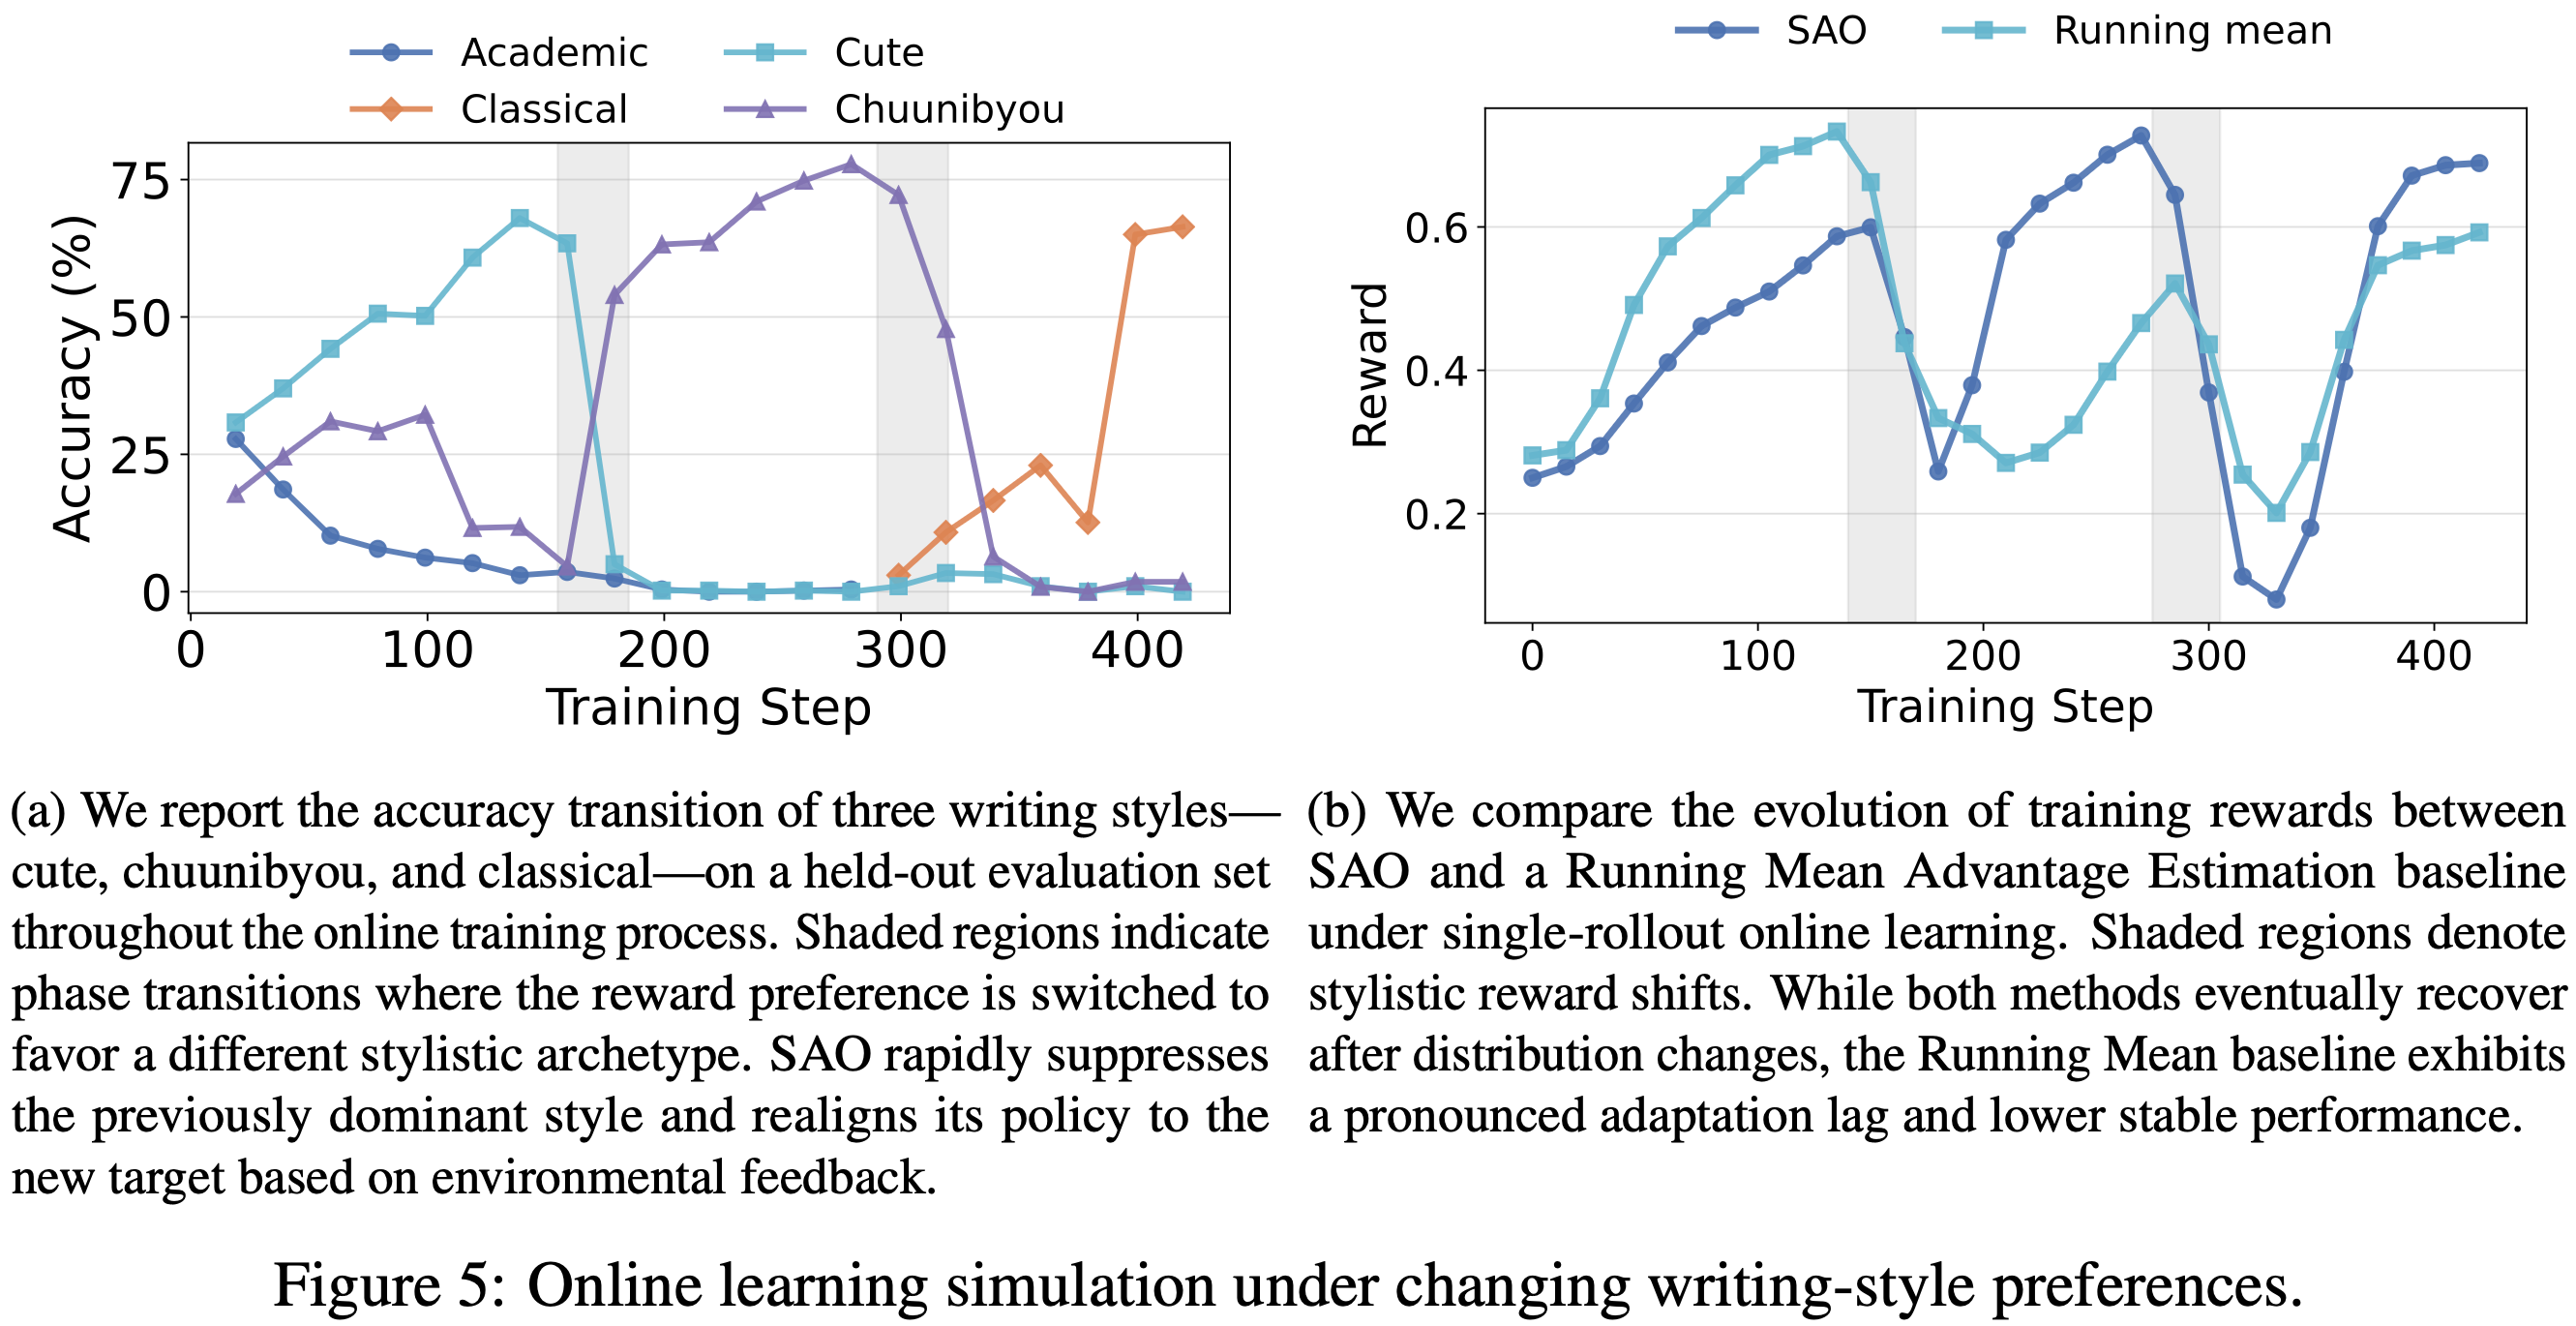
- 本文设计了一个模拟的在线写作任务,以评估 SAO 在非平稳环境中的适应性
- 在此 Setting 中,反馈信号被设计为用户偏好的语言语气
- 奖励标准依次调整为三种不同的风格类型:可爱 (cute)、中二 (chunibyou) 和古典 (classical)
- 在现实世界的在线学习环境中,反馈通常限制为每个 Prompt 单条轨迹
- Dynamic Reward Assignment
- 对于奖励信号分配,采用 GLM-4.7 作为 Judge,评估两个主要维度:响应质量和风格符合度
- 最终奖励 \(r \in \{0, 1\}\) 计算为:
$$ r = r_{\text{quality} } \times r_{\text{style} } $$- \(r_{\text{quality} }, r_{\text{style} } \in \{0, 1\}\) 表示二元奖励
- 在整个训练过程中,System Prompt 要求模型从四个候选风格原型中选择一个:Academic、Cute、Chunibyou 和 Classical
- 在实际实验中,前两个阶段的候选集合为 {Academic, Cute, Chunibyou},最后一个阶段为 {Classical, Cute, Chunibyou}
- Results
- 如图 5a 所示,在每个阶段的保留测试集上评估三种候选语言风格的性能
- SAO 在每次奖励偏好转换后均表现出快速的策略重新对齐,其特征是风格原型之间的转换,以保持对不断变化的环境反馈的遵循
- Comparison against Running-Mean Baseline
- 为了更好地理解价值模型在在线环境中的有效性,还采用 Running Mean Advantage Estimation 方法作为基线
- 理解:相对使用滑动平均的估计方式,Critic 模型能更快识别到线上发生的偏好变化
- 该方法通过跟踪最近 128 个奖励的滑动窗口来近似基线 \(b\),从而计算优势 \(\hat{A} = r - \mathbb{E}[r_{window}]\)
- 通过将优势估计与 Prompt 内样本组解耦,此设置允许在在线单 Rollout 背景下进行策略优化
- 图 5b 展示了 SAO 和 Running Mean 基线在整个在线学习过程中训练奖励的演变,其中风格转换后奖励恢复的速度和幅度是算法适应性的关键指标
- Running Mean 基线由于历史窗口的惯性而表现出明显的适应滞后,该窗口在转换后仍暂时偏向先前分布的奖励
- SAO 基于价值的 Critic 动态跟踪奖励变化,促进快速恢复并持续达到更高的收敛水平
- 这证实了 SAO 的状态相关基线提供了非平稳环境中有效对齐所需的精度
- 为了更好地理解价值模型在在线环境中的有效性,还采用 Running Mean Advantage Estimation 方法作为基线
Related Work
Reinforcement Learning for Language Models
- 标准的 RLHF 流程从偏好数据训练奖励模型,并使用 PPO (2022; 2017) 优化策略
- 为了降低价值函数学习的开销和不稳定性,无 Critic 的目标函数如 GRPO 和 REINFORCE 风格的基线(例如 RLOO)(2024) 变得越来越流行
- GRPO 通过在 Prompt 级别组内对奖励进行归一化来形成优势,这在同步训练中提高了稳定性,但引入了隐式同步屏障:更新必须等待组内所有成员生成完毕,从而在异步条件下加剧陈旧性和 Off-policy 漂移
- 最近的工作进一步改进 GRPO/PPO 风格的目标函数,以提高稳定性和方差降低,包括序列级重要性加权 (2025)、自适应裁剪策略 (2025b) 以及对硬裁剪的更平滑替代方案 (2025)
- 这些工作主要关注同步 RL,其中精确的重要性采样比率更容易获得
- 用于异步 RL 的重要性采样和裁剪策略仍较少被探索
Synchronous and Asynchronous RL for LLMs
- 大多数大规模 LLM RL 实现仍然是同步和交错式的:使用固定的策略快照收集完整的 Rollout 批次,然后在该批次上运行优化轮次 (2022)
- 在推理和工具使用中存在长尾输出长度时,同步屏障会导致落后者和大量空闲时间,从而促使采用异步 Actor-Learner 设计,其中 Rollout 生成和学习并发进行 (2016; 2018)
- 但异步引入了策略滞后和 Off-policy 漂移,通常需要陈旧性感知训练或 Off-policy 校正 (2018)
- 最近有几个系统专门针对 LLM 的异步 RL
- (2024) 将异步 RLHF 作为在线但 Off-policy 学习进行研究,并刻画了鲁棒性权衡
- 在系统方面
- AREaL (2025) 将 Rollout 与训练完全解耦,并针对推理任务采用陈旧性感知的 PPO 风格更新
- ROLL Flash 为 RLVR 和 Agentic 训练提供细粒度并行性和 Rollout-训练解耦 (2025)
- 与异步系统互补地,
- MobileRL 研究面向移动 GUI Agent 的在线 Agentic RL,并引入难度自适应的 GRPO 变体,以提高多轮 GUI 环境中的稳定性和样本效率 (2025)
- 本文工作与这些系统互补,专注于单 Rollout Setting(在此设置中基于组的基线(如 GRPO)在结构上不匹配),并通过算法设计稳定异步学习
附录 A:Additional Experimental Results
A.1 RL with Agentic Step as Action
- 结论前置:
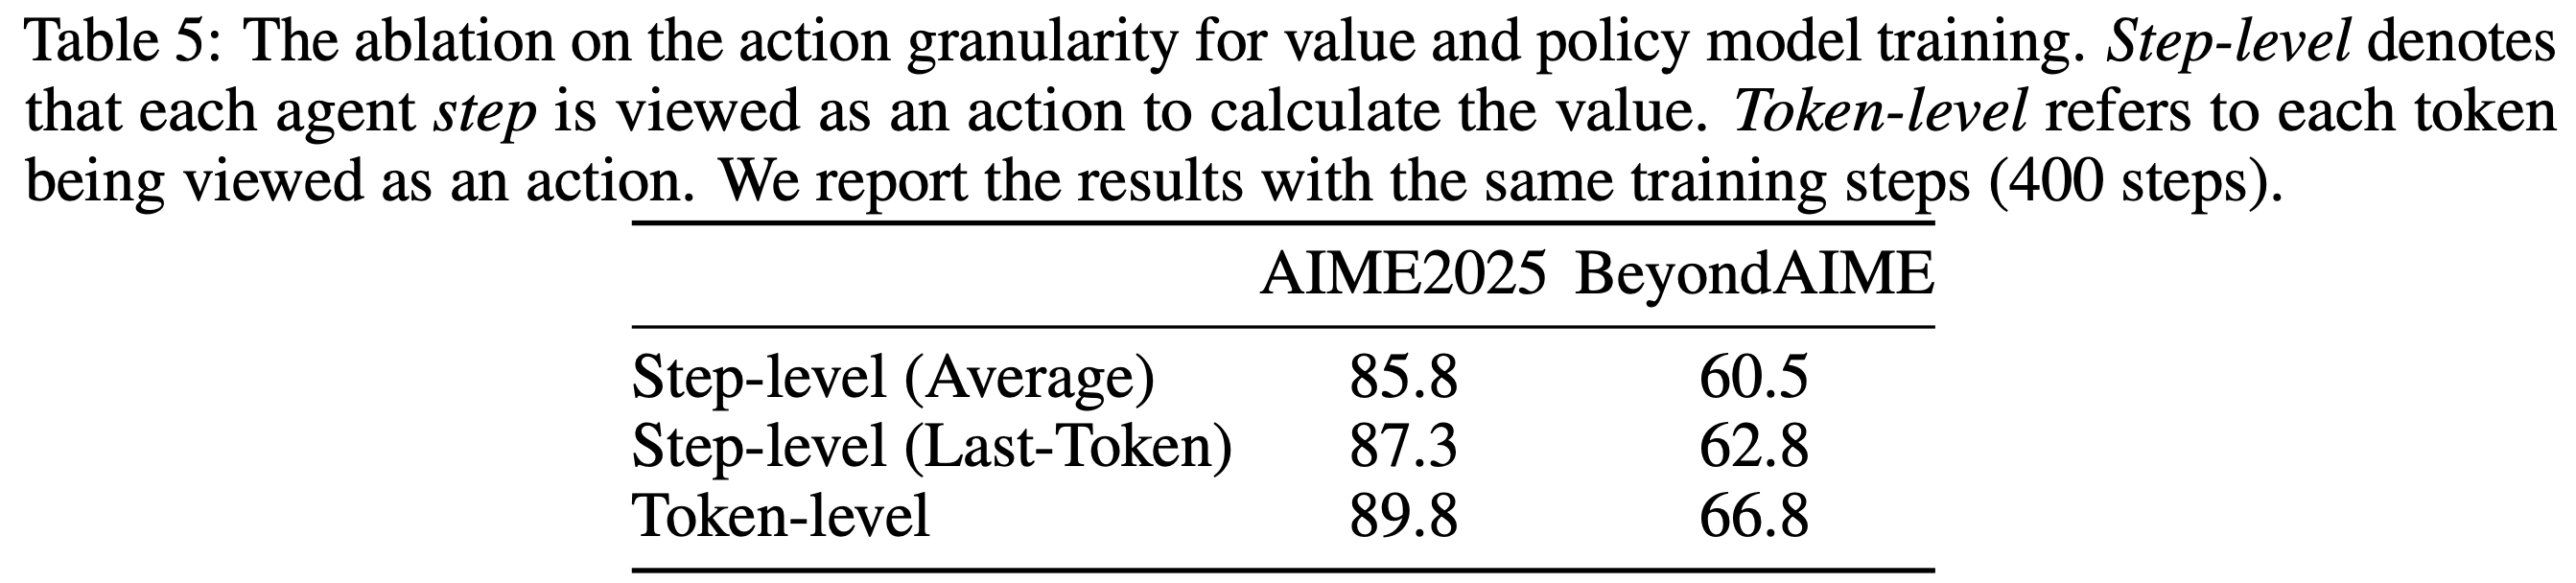
- 论文尝试了将整个 Step(一次完整的推理或工具调用)视为一个 Action 来计算 GAE(Step-Average 或 Last-Token)
- 结论是 :Token-level 的训练效果(AIME 89.8%)显著优于 Step 级(Last-Token 87.3%)
- 作者推测原因是 Token 级提供了更细粒度的监督信号,能更精准地捕捉复杂推理轨迹中的逻辑转折点
- 为缓解 token 级价值预测固有的高方差,作者实现了 step-wise GAE 计算
- 将一个步骤(记为 \(S_{i}\))定义为单轮对话,并假设该步骤内的所有组成 token 共享统一的学习信号
- 基于组成 token 的价值预测 \(\{v_{i,1},v_{i,2},\ldots ,v_{i,n}\}\),使用两种主要聚合方法定义步骤级价值 \(V(S_{i})\):
- Step Average : 步骤价值是该步骤内所有 token 价值预测的平均值
$$V(S_{i}) = \frac{1}{n}\sum_{j = 1}^{n}v_{i,j} $$- 在此设置中,价值模型在所有 token 上进行训练
- Last-Token Prediction : 将步骤价值定义为 仅使用每个步骤的最后一个 token
$$ V(S_{i}) = v_{i,n}$$- 假设最后一个 token 提供了该步骤最准确的价值预测,因为它包含了整个单元最全面的信息
- 在价值模型训练期间,对所有中间 token 应用损失掩码,确保只有每个步骤的最后一个 token 对优化有贡献
- Step Average : 步骤价值是该步骤内所有 token 价值预测的平均值
- 为了提供更稳定的学习信号,还实现了步骤级 GAE 计算,将优势估计从 token 级转移到步骤级粒度
- 基于步骤级 TD 误差 \(\delta_{i} = R_{i} + \gamma V(S_{i + 1}) - V(S_{i})\) 为每个步骤推导出单一优势 \(\hat{A}_{i}\)
- 然后将该优势均匀地分配给对应步骤内的所有 token,从而有效平滑自回归生成中普遍存在的局部噪声
- 此外,长度自适应的 GAE 机制被修改为基于总步骤数而非原始 token 长度来缩放衰减因子 \(\lambda\),其中
$$\lambda_{\text{policy} } = 1 - \frac{1}{\alpha \times \text{step number} }$$
- 结果:如图 6 中的训练奖励和表 5 中的性能结果所示,两种步骤级方法均不如 token 级价值训练
- 作者将此失败归因于 token 级训练为 Critic 和策略都提供了更细粒度的监督信号,这对于在复杂推理轨迹中准确捕捉逻辑转换至关重要

- 作者将此失败归因于 token 级训练为 Critic 和策略都提供了更细粒度的监督信号,这对于在复杂推理轨迹中准确捕捉逻辑转换至关重要
- 表 5:关于价值和策略模型训练的动作粒度的消融实验
- 步骤级表示每个 Agent 步骤被视为一个动作来计算价值
- Token 级表示每个 token 被视为一个动作
- 这里报告相同训练步数(400 步)下的结果
A.2 Comparison to Other Baselines of Single-Rollout Strategies
- SPO (2025) 或直接使用历史 Running-mean 奖励作为优势估计的基线也是实现每个 Prompt 单 Rollout RL 的可行方法
- 但 SPO 和 Running-mean 基线依赖于训练数据难度的先验信息,且性能不如 SAO,如实验部分所示
附录 B:Limitations and Broader Impact
- 本文实验集中在大型 Agentic 推理、Coding 和模拟在线写作任务上,使用 Qwen3-30B-A3B 作为主干
- 结论可能无法直接迁移到更小的模型、非 Agentic 的 RLHF 设置,或具有密集奖励和更短 Rollout 的环境
- SAO 依赖于训练好的价值模型和 Rollout log 概率,因此部署需要能够可靠地在异步生成期间保留 token 级行为概率的基础设施
- SAO 对基础设施有硬性要求,即系统必须能在异步生成期间可靠地保存 Token 级别的行为概率(Log-probabilities) ,这是计算 DIS 中 \(r_t(\theta)\) 的前提